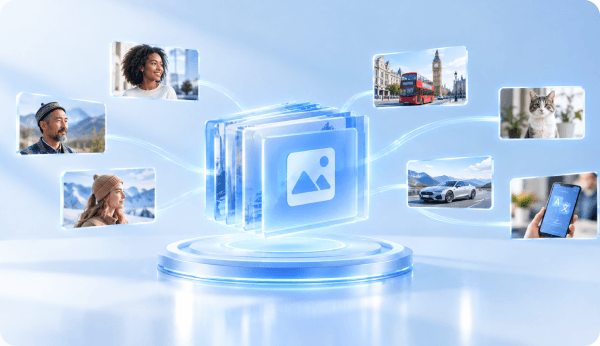
在模型能力快速迭代的背景下,高质量数据集正成为决定模型效果的关键变量。淘丁数科结合项目实践,梳理从数据采集、标注到模型评测的完整路径。
数据质量直接影响模型的泛化能力与稳定性。相比单纯扩大数据规模,围绕真实业务场景构建高质量、可评测的数据集,往往更具性价比。
从数据标注到质量闭环
在数据处理流程中,规范化的标注体系、多维度的质检规则与持续迭代的反馈机制缺一不可。淘丁数科通过人机协同的生产方式,在保证效率的同时控制数据噪声。
“数据不是越多越好,而是越贴合场景、越可评测越好。”
— 淘丁数科数据团队
随着多模态与具身智能的发展,数据集建设将更加注重真实性与多样性,这也对数据生产能力提出了更高要求。